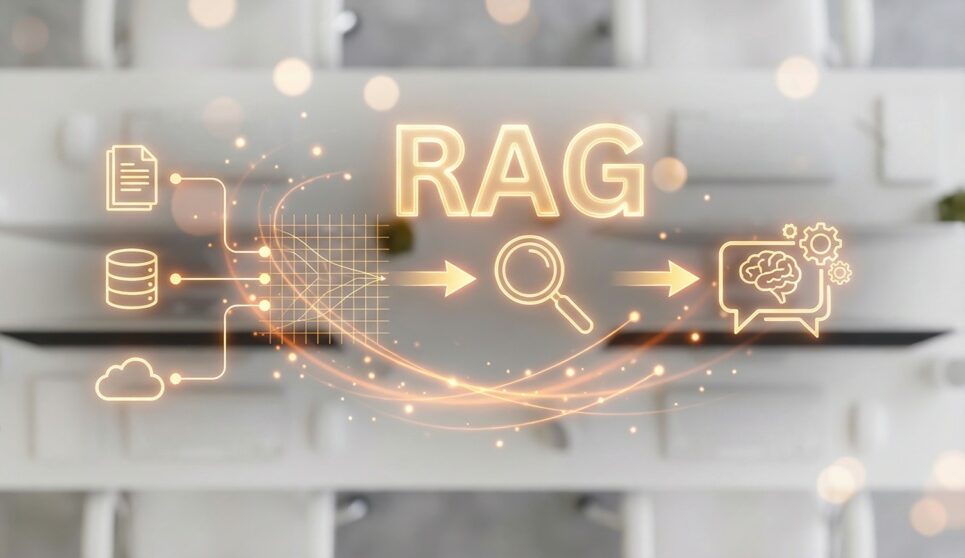
RAG (Retrieval-Augmented Generation) to architektura AI, w której model językowy przed wygenerowaniem odpowiedzi wyszukuje najtrafniejsze fragmenty z zewnętrznej bazy wiedzy i dołącza je do promptu jako kontekst. Dzięki temu model odpowiada na podstawie Twoich dokumentów, a nie tylko wiedzy zapamiętanej podczas treningu.
Zatem odpowiadając w jednym zdaniu: RAG to sposób pracy z AI, w którym Large Language Model najpierw szuka, a dopiero potem odpowiada — i robi to na podstawie zewnętrznej bazy, a nie wiedzy nabytej w ramach trenowania modelu .
Co to jest RAG ?
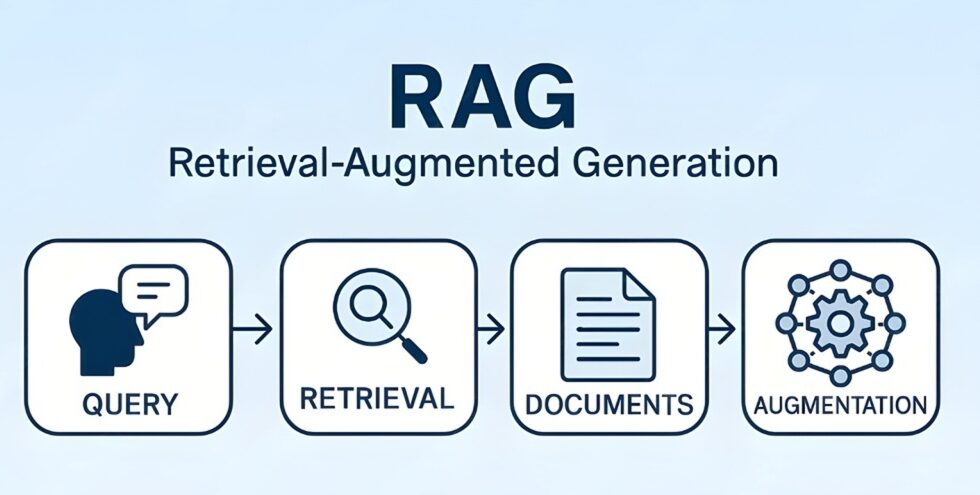
- Retrieval — wyszukiwanie. System najpierw przeszukuje bazę wiedzy pod kątem fragmentów pasujących do pytania.
- Augmented — wzbogacone. Znalezione fragmenty są doklejane do pytania jako dodatkowy kontekst.
- Generation — generowanie. Dopiero teraz model językowy (LLM) pisze odpowiedź na podstawie dostarczonego materiału.
Najprostsza metafora: zwykły model językowy to student zdający egzamin z pamięci — posiada pewną wiedzę, ale gdy trafi na pytanie spoza materiału, próbuje zgadnąć prawidłową odpowiedź. RAG to ten sam student, ale na egzaminie z otwartą książką — dostaje pytanie, znajduje właściwy rozdział, czyta go i odpowiada na podstawie pozyskanej wiedzy. Ma zatem prostu dostęp do źródła w momencie, gdy go potrzebuje i przedstawia dużo lepszą odpowiedź.
Termin i architekturę RAG wprowadziła w 2020 roku praca Lewisa i in. z Meta AI Research (NeurIPS 2020). Praktyczne zastosowanie na szeroką skalę przyszło dopiero wtedy, gdy modele językowe stały się wystarczająco dobre, żeby sensownie korzystać z podanego im kontekstu.
Dlaczego modele językowe w ogóle potrzebują wyszukiwania?
Dwa twarde ograniczenia tworzą tę potrzebę:
- Trening ma datę końcową. Model wytrenowany do początku 2026 roku nie wie nic o tym, co wydarzyło się później. Ponowne trenowanie modelu klasy frontier to wielomiesięczny, ogromnie kosztowny projekt. Systemy RAG zatem pozwalają modelom językowym odpowiadać na pytania z późniejszego okresu.
- Dane treningowe były publiczne. Twoje faktury, zgłoszenia klientów i wewnętrzne procedury nigdy nie były przetwarzane — i żadne formułowanie promptów tego nie zmieni. Wyszukiwanie to jedyny sposób, żeby ogólny model odpowiadał na podstawie prywatnych danych.
Jest też trzeci powód, mniej oczywisty: ugruntowanie (grounding). Kiedy odpowiedź musi wynikać z podanego fragmentu, model może zacytować źródło — a Ty możesz je sprawdzić. Odpowiedź wygenerowana „z pamięci” nie daje niczego do weryfikacji, a to właśnie ten rodzaj błędu sprawia, że halucynacje są niebezpieczne.
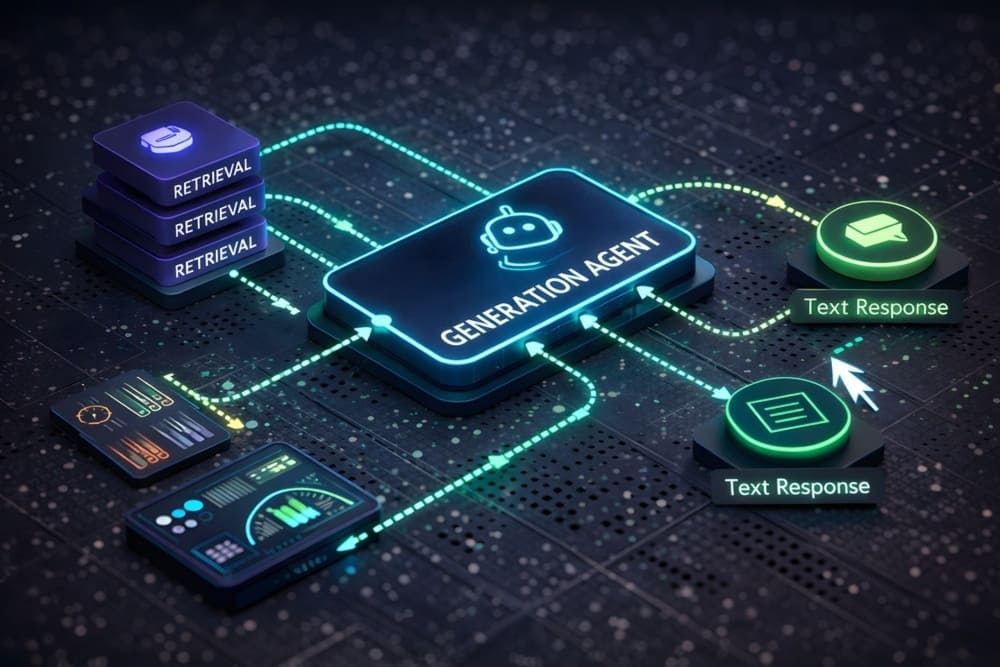
Jak działa RAG krok po kroku
Cały proces ma kilka etapów i dzieje się w kilka sekund, bez udziału człowieka. Warto rozłożyć go na czynniki pierwsze, bo reszta artykułu bazuje na tych krokach.
Indeksowanie dokumentów i chunking
Zanim system zacznie odpowiadać, trzeba przygotować bazę wiedzy. Dokumenty (PDF-y, DOCX-y, strony wiki, e-maile, arkusze) są dzielone na mniejsze fragmenty zwane chunkami — zwykle po kilkaset tokenów każdy. Jest to konieczne z dwóch powodów: model ma limit okna kontekstu, a wyszukiwanie działa na fragmentach, nie na całych plikach.
Dobry chunking respektuje strukturę dokumentu: dzieli po nagłówkach, akapitach, sekcjach umów. Zły — tnie dokumenty równo co 512 znaków i przecina zdania w połowie.
Embeddingi i baza wektorowa
Każdy chunk jest zamieniany na embedding — listę liczb reprezentującą jego znaczenie. Teksty o podobnym sensie dostają podobne zestawy liczb, nawet jeśli nie mają wspólnych słów. Dzięki temu zdanie „co jeśli sprzęt się zepsuje po roku” i akapit o warunkach gwarancji wylądują blisko siebie w przestrzeni wektorowej.
Embeddingi trafiają do bazy wektorowej — bazy danych zaprojektowanej do błyskawicznego znajdowania najbardziej podobnych reprezentacji. Zwykła baza odpowiada na pytanie „gdzie jest dokładnie ta wartość”. Baza wektorowa odpowiada na pytanie „co jest najbliżej znaczeniowo”.
Popularne rozwiązania: Pinecone (managed cloud), Qdrant i Weaviate (open source, self-hosted), pgvector (rozszerzenie PostgreSQL) oraz FAISS (biblioteka do lokalnego wyszukiwania).
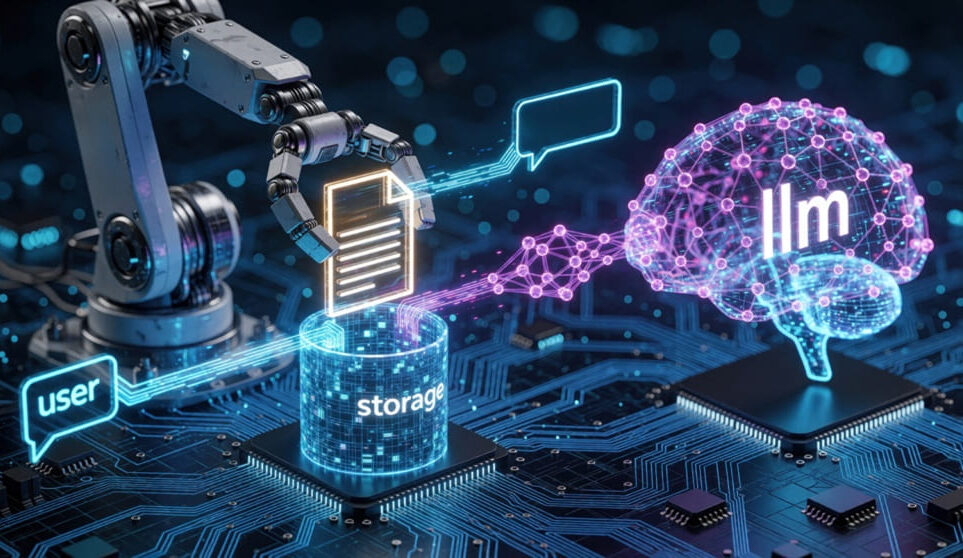
Retrieval, augmentacja promptu i generowanie
Gdy użytkownik zadaje pytanie, dzieje się sekwencja:
- Pytanie jest zamieniane na embedding tym samym modelem, którego użyto do indeksowania.
- System przeszukuje bazę wektorową i zwraca top-k najbliższych fragmentów (typowo 3-10).
- Opcjonalnie działa reranker — dokładniejszy, ale wolniejszy model, który porządkuje kandydatów według trafności.
- Fragmenty trafiają razem z pytaniem do promptu, opatrzone instrukcją w stylu: „Odpowiedz wyłącznie na podstawie poniższych fragmentów. Jeśli nie ma w nich odpowiedzi — powiedz, że nie wiesz.”
- Model językowy generuje odpowiedź, najlepiej z cytowaniem źródeł.
To właśnie ta sekwencja odróżnia RAG od zwykłej rozmowy z ChatGPT. Model przestaje być źródłem wiedzy, a staje się warstwą, która tę wiedzę czyta i tłumaczy na zrozumiały język.
Architektura technologii RAG i kluczowe komponenty
Typowy system RAG składa się z kilku współpracujących elementów. Zrozumienie ich pozwala ocenić, czy vendor sprzedaje prawdziwy RAG, czy prosty search plus GPT.
| Komponent | Rola |
|---|---|
| Baza wiedzy | Zewnętrzne źródło dokumentów, do którego system sięga |
| Model embeddingowy | Zamienia tekst (pytania użytkowników i chunki) na wektory |
| Baza wektorowa | Przechowuje wektory i umożliwia szybkie wyszukiwanie podobieństwa |
| Retriever | Wybiera top-k fragmentów pasujących do pytania |
| Reranker (opcjonalny) | Druga warstwa sortowania kandydatów po trafności |
| Generator (LLM) | Tworzy odpowiedź na podstawie pytania i dostarczonego kontekstu |
| Warstwa integracji | Orkiestruje całość, buduje prompt, zarządza formatem odpowiedzi |
Kluczowe decyzje techniczne, które przesądzają o jakości RAG:
- Rozmiar chunków — za małe (100 tokenów) tracą kontekst, za duże (2000+) drogo i gorzej wyszukują. Typowo 300-800 tokenów.
- Overlap między chunkami — 10-20% nakładki zapobiega gubieniu kontekstu na granicach.
- top_k retrieval — ile fragmentów podać modelowi. Typowo 3-10; powyżej 15 model zaczyna się „gubić”.
- Reranking — druga warstwa oceny par pytanie-fragment; poprawia jakość o 15-25%.
- Wyszukiwanie hybrydowe — połączenie wektorów z BM25; łapie zarówno znaczenie, jak i nazwy własne, kody i sygnatury.
RAG vs fine-tuning vs długi kontekst
To najczęstsza pomyłka w całym temacie. RAG, fine-tuning i wklejanie długiego kontekstu to trzy różne narzędzia do trzech różnych problemów — i bywają mylone, bo wszystkie „uczą model Twoich danych”. Robią to jednak w niekompatybilny sposób.
| Kryterium | RAG | Fine-tuning | Długi kontekst |
|---|---|---|---|
| Gdzie jest wiedza | W zewnętrznej bazie | Wewnątrz modelu (w wagach) | W promptcie, przy każdym zapytaniu |
| Aktualizacja wiedzy | Dodajesz plik do bazy | Wymaga ponownego treningu | Natychmiastowa, ale płatna za każdy token |
| Możliwość cytowania źródła | Tak | Nie | Ograniczona |
| Koszt jednostkowy zapytania | Średni, rośnie z liczbą fragmentów | Niski po treningu | Wysoki — płacisz za cały kontekst |
| Główne ryzyko | Złe wyszukiwanie → odpowiedź z niewłaściwego fragmentu | Utrwalenie nieaktualnych danych | Gubienie informacji w środku okna kontekstowego |
| Kiedy wybrać | Wiedza zmienna, wymóg cytowania | Stały styl, format, terminologia | Pojedyncze, długie dokumenty |
Ekonomia decyduje bardziej niż teoria. Wklejenie 300 000 tokenów podręcznika przy każdym pytaniu kosztuje około 0,60 USD przy stawce 2 USD za milion tokenów wejściowych. Wyszukanie i wklejenie 2000 tokenów — mniej niż pół centa. Przy trzech pytaniach długi kontekst jest około 100 razy droższy za te same odpowiedzi.
W praktyce najczęściej łączy się RAG z fine-tuningiem: fine-tuning uczy model pożądanego stylu i formatu, a RAG dostarcza aktualne fakty. Dla 80-90% zastosowań biznesowych wystarcza sam RAG.
Zastosowania RAG w firmie
RAG sprawdza się wszędzie tam, gdzie odpowiedź musi pochodzić z konkretnych, firmowych materiałów. Pięć zastosowań pojawia się najczęściej.
Wewnętrzna baza wiedzy
Najpopularniejsze zastosowanie. Pracownik pyta chatbota „ile dni urlopu na żądanie mi przysługuje”, a RAG odpowiada na podstawie regulaminu, nie ogólnej wiedzy o polskim prawie pracy. Nowi juniorzy przestają zasypywać seniorów tymi samymi pytaniami o procesy wewnętrzne — a seniorzy odzyskują 3-5 godzin tygodniowo.
Obsługa klienta i chatboty
Chatbot wyposażony w RAG ma dostęp do pełnej bazy wiedzy firmy: regulaminów, cenników, dokumentacji produktu, historycznych zgłoszeń. Odpowiada na pytania, które nigdy wcześniej się nie pojawiły, a sprawy, których nie znajdzie w bazie, przekazuje człowiekowi. Wdrożenia w obsłudze klienta często redukują liczbę ticketów obsługiwanych ręcznie o 50-60%.
Prawo, compliance i analiza dokumentów
Kancelarie prawne używają RAG do przeszukiwania archiwów umów, znajdowania precedensów i cytowania konkretnych paragrafów. Prawnik wkleja klauzulę, system zwraca top 5 podobnych klauzul z historycznych umów wraz z finalnymi decyzjami. To skrócenie analizy z 2-4 godzin do kilkunastu minut na dokument — pod warunkiem, że baza jest czysta.
E-commerce i rekomendacje
Wyszukiwarka produktowa oparta na RAG rozumie pytania w języku naturalnym i odpowiada konkretami. System może analizować katalog, specyfikacje techniczne, opinie klientów i politykę zwrotów, a następnie generować odpowiedzi dopasowane do potrzeb konkretnego użytkownika.
Asystenci wiedzy w organizacjach
RAG demokratyzuje dostęp do wiedzy rozproszonej po działach i systemach. Młodszy analityk może zadać agentowi pytanie i dostać odpowiedź opartą na dziesięciu latach raportów — coś, co wcześniej wymagałoby zaangażowania doświadczonych pracowników lub długiego researchu.
Korzyści i ograniczenia RAG
Co RAG daje firmie:
- Aktualność — odpowiedzi oparte na najnowszych wersjach dokumentów, bez retrenowania modelu.
- Wiarygodność — możliwość wskazania źródła każdej odpowiedzi i zweryfikowania jej.
- Oszczędność — technologia RAG jest 5-10 razy tańsza niż fine-tuning tego samego modelu, a aktualizacja wiedzy to podmiana pliku w bazie.
- Kontrola — widzisz, z jakich dokumentów system korzysta, i możesz w każdej chwili usunąć informację z bazy (istotne choćby przy RODO).
- Skalowalność — jeden model obsłuży szeroki zakres zapytań, o ile podłączysz odpowiednie zbiory wiedzy.
Gdzie RAG zawodzi
- Nietrafione wyszukiwanie — jeśli retriever wyciągnie niewłaściwe fragmenty, model odpowiada płynnie na podstawie nieistotnego kontekstu. Symptom: odpowiedź cytuje Twój dokument, ale odnosi się do lekko innego pytania.
- Nieaktualne indeksy — baza wektorowa zna dokumenty z chwili ostatniego indeksowania. System działający na danych z zeszłego kwartału daje pewne siebie, przestarzałe odpowiedzi z cytatami, co jest gorsze niż zwykła halucynacja, bo bardziej przekonujące.
- Sprzeczne źródła — kiedy fragmenty są niezgodne, modele mają tendencję do zlepiania ich w jeden gładki, błędny akapit zamiast zaznaczyć konflikt.
- Pytania wymagające agregacji — „ile umów podpisaliśmy w 2023 roku?” to zadanie dla bazy danych i SQL, nie dla RAG.
Halucynacje aplikacji AI — czy RAG je eliminuje?
RAG ogranicza halucynacje, ale nie ich nie usuwa. Dobrze wdrożone modele RAG redukują halucynacje z 40-60% (model standalone) do 5-15% — ale nie do zera. Halucynacje w RAG mają trzy główne źródła:
- Brak odpowiedzi w bazie — źle skonfigurowany system dopowie coś z ogólnej wiedzy modelu.
- Zły fragment w wynikach — pytasz o termin wypowiedzenia, a system trafia na termin płatności.
- Błędna interpretacja dobrego fragmentu — zwłaszcza przy zawiłych klauzulach umów i specyfikacjach.
Obrona przed halucynacjami jest zatem trojaka: prompt:„odpowiadaj tylko na podstawie kontekstu, a jeśli brak odpowiedzi — powiedz to wprost”, cytowanie źródeł przy każdej odpowiedzi oraz — przede wszystkim — rzetelna baza wiedzy. RAG nie naprawi błędnej i niepełnej bazy danych.
Jak wdrożyć RAG w praktyce
Sanitacja bazy wiedzy
To najczęściej pomijany i najdroższy etap. W naszej praktyce (podczas pracy dla klientów Deployance) pochłania 40-60% czasu wdrożenia — i to jest właściwa proporcja. Konkretne działania:
- OCR wszystkich skanów PDF (2-4 tygodnie pracy, około 15 tys. PLN dla firmy zewnętrznej).
- Audyt prawny bazy — oznaczenie „aktualne / uchylone / draft / final” (4-8 tygodni, około 20 tys. PLN).
- Deduplikacja i standaryzacja formatów.
- Metadata schema (typ dokumentu, data ważności, autor) dodane do każdego chunka.
Historia z praktyki: kancelaria prawnicza, która pominęła sanitację bazy danych, po czterech tygodniach użytkowania miała 60% odpowiedzi z halucynacjami. Aplikant przygotował opinię z wymyślonym wyrokiem Sądu Najwyższego, klient odszedł do konkurencji, a partner zawiesił projekt po sześciu tygodniach — strata 35 tys. PLN plus utrata reputacji kancelarii.
Wybór modelu embeddingowego
Dla polskich dokumentów sprawdzaj ranking PL-MTEB zamiast kierować się nazwą. Warto testować modele wielojęzyczne (multilingual-e5, BGE-M3) i polskie (MMLW). Jakość odpowiedzi zależy głównie od tego wyboru — świetne Large Language Models z przeciętnym embeddingiem daje niestety przeciętne rezultaty.
Ewaluacja jakości oraz monitorowanie
Bez mechanizmu mierzenia jakości nie wiesz, czy system działa, czy tylko wygląda, że działa. Minimum:
- Zbiór 50-100 par pytanie-oczekiwana odpowiedź przygotowany przed go-live.
- Metryki osobno dla wyszukiwania (czy właściwy fragment jest w top-k) oraz dla generacji (czy odpowiedź jest wierna źródłom).
- Narzędzia typu RAGAS lub Langfuse do śledzenia jakości w produkcji.
- Regularny przegląd logów i feedbacku użytkowników.
Koszty i ryzyka wdrożenia RAG
Widełki z praktyki 2024-2026 dla polskich firm B2B (TCO 12 miesięcy):
| Tier | Architektura | Setup one-time | Runtime/mc | TCO 12 mies. | Dla kogo |
|---|---|---|---|---|---|
| Tier 1 | Managed (OpenAI Assistants API) | 15-30 tys. PLN | 500-2 000 PLN | 21-54 tys. PLN | Mikro, 20-100 dokumentów |
| Tier 2 | Self-hosted (LangChain + Qdrant/Pinecone) | 30-80 tys. PLN | 2-8 tys. PLN | 54-176 tys. PLN | Mała-średnia, 500-10 tys. dokumentów |
| Tier 3 | Hybrid (on-prem DB + cloud LLM) | 80-200 tys. PLN | 8-30 tys. PLN | 176-560 tys. PLN | Enterprise, 10 tys.+ dokumentów |
Uwaga na ukryte koszty, których vendor nie pokazuje w propozycji: sanitacja bazy (10-40 tys. PLN jednorazowo), reranking (3-10 tys. PLN/rok), monitoring (5-15 tys. PLN/rok), guardrails i bezpieczeństwo (10-30 tys. PLN/rok), migracja embeddingów co 6-12 miesięcy (5-20 tys. PLN). Realny TCO bywa o 40-60% wyższy niż propozycja handlowa.
Kiedy RAG nie ma sensu
Cztery scenariusze, w których RAG nie jest właściwym wyborem:
- Pytania o powszechną wiedzę — jeśli zapytania użytkowników dotyczą tego, co Google wie z treningu, RAG nie jest potrzebny. Wystarczy zastosować standardowe wyszukiwanie web search oraz użyć właściwego promptu.
- Dane w czasie rzeczywistym — kursy walut, stany magazynowe live, statusy zamówień. RAG operuje na wektorach z wcześniej przygotowanej bazy; tu lepiej sprawdza się function calling do API Twojego ERP/CRM.
- Kreatywne pisanie i stały styl marki — jeśli AI ma pisać artykuły marketingowe w stylu Twojej marki, fine-tuning jest lepszym rozwiązaniem. RAG nie jest w stanie zachować odpowiedniej stylistyki, charakterystycznej dla twojego przekazu marketingowego.
- Mikro-firma bez udokumentowanej bazy wiedzy — jeśli firma 3-osobowa nie posiada ustematyzowanej bazy wiedzy, RAG nie ma możliwości skorzystać z bazy wiedzy. Najpierw należy zatem stworzyć dokumentację, dopiero później korzystać z rozwiązań RAG.
Uczciwa diagnoza: około 25-30% firm, które pytają mnie o RAG, nie powinno go wdrażać w tym momencie. Najpierw udokumentowana baza wiedzy, jasne use case’y z mierzalnym ROI i budżet TCO na 12 miesięcy.
FAQ
Jak opisać RAG w prostych słowach?
RAG to sposób budowania asystentów AI, który łączy dwa etapy: najpierw system wyszukuje w Twojej bazie dokumentów fragmenty najbardziej trafne dla pytania, a potem daje je modelowi językowemu jako kontekst do wygenerowania odpowiedzi. Efekt: AI odpowiada na podstawie Twoich dokumentów, nie tylko wiedzy z treningu.
Jak działa RAG krok po kroku?
Pytanie użytkownika jest zamieniane na wektor liczbowy. System wyszukuje w bazie wektorowej fragmenty o najbliższym znaczeniu. Znalezione fragmenty trafiają razem z pytaniem do modelu językowego, który formułuje odpowiedź wyłącznie na podstawie dostarczonego materiału. Cały proces trwa kilka sekund.
Czy RAG eliminuje halucynacje?
Nie eliminuje, ale wyraźnie je ogranicza — z 40-60% do 5-15% w dobrze wdrożonym systemie. Halucynacje nadal mogą się zdarzyć, gdy baza zawiera sprzeczne informacje, fragment jest źle dobrany albo model błędnie interpretuje dobry fragment. Dlatego odpowiedzi powinny być cytowane, a źródła weryfikowalne.
Czym różni się RAG od fine-tuningu?
Fine-tuning doucza model na Twoich danych — wiedza trafia na stałe do jego wag, a każda aktualizacja wymaga ponownego treningu. RAG niczego w modelu nie zmienia: dane podaje jako kontekst przy każdym pytaniu. RAG jest tańszy, szybszy we wdrożeniu i pozwala aktualizować dane przez dodanie pliku do bazy. W skrócie: RAG dokłada wiedzę, fine-tuning zmienia styl i zachowanie.
Ile kosztuje wdrożenie RAG w polskiej firmie B2B?
Widełki z praktyki: Tier 1 (Managed, mikro) 21-54 tys. PLN TCO rocznie, Tier 2 (Self-hosted, mała-średnia) 54-176 tys. PLN, Tier 3 (Hybrid, enterprise) 176-560 tys. PLN. Realny TCO bywa o 40-60% wyższy niż propozycja vendora, bo zawiera sanitację bazy, reranking, monitoring i guardrails.
Czy RAG działa dobrze z dokumentami po polsku?
Tak, jeśli model embeddingów i model generujący obsługują polski — dokumentów nie trzeba tłumaczyć. Do wyszukiwania w polskich tekstach są gotowe modele: MMLW, multilingual-e5-large, BGE-M3. Jakość odpowiedzi zależy głównie od tego wyboru; sprawdzaj ranking PL-MTEB.
Czy potrzebuję bazy wektorowej?
Przy kilku tysiącach fragmentów wystarczy zwykłe przeszukanie wszystkich wektorów w pamięci. Specjalizowana baza wektorowa lub indeks przybliżony (HNSW) opłaca się przy setkach tysięcy i milionach fragmentów.
Czy RAG można zbudować bez programowania?
Tak. Narzędzia no-code, jak n8n, Make.com, a także gotowe produkty (NotebookLM, projekty w Claude z wbudowanym RAG) pozwalają uruchomić działający system bez pisania kodu. Do testu pomysłu wystarczy wgranie dokumentów i zadawanie pytań.
Kiedy RAG nie ma sensu?
Gdy pytania użytkownika dotyczą powszechnej wiedzy (web search wystarczy), danych w czasie rzeczywistym (potrzebne API), kreatywnego pisania w stałym stylu (lepszy fine-tuning) albo gdy firma nie ma udokumentowanej bazy wiedzy (najpierw dokumentacja, potem RAG).
Podsumowanie
RAG w jednym zdaniu: sposób na to, żeby AI odpowiadało na podstawie Twoich danych, zamiast zgadywać z pamięci. To dlatego jest dziś najskuteczniejszą obroną przed halucynacjami — model nie wytworzy dokumentu, którego nie ma w bazie.
Trzy rzeczy warte zapamiętania:
- Kolejność ma znaczenie — najpierw wyszukiwanie w bazie, potem generowanie odpowiedzi. Nigdy odwrotnie.
- Baza wektorowa szuka po znaczeniu, nie po słowach kluczowych — dlatego działa nawet wtedy, gdy pytanie brzmi zupełnie inaczej niż dokument.
- RAG to nie fine-tuning — pierwszy dokłada wiedzę, którą można w każdej chwili zaktualizować, drugi zmienia zachowanie modelu i wymaga przetrenowania.
Największą wartością RAG nie jest nawet to, że model wie więcej. Jest nią to, że wie, skąd wie — a gdy nie znajdzie odpowiedzi w Twoich materiałach, potrafi się do tego przyznać. Przy zastosowaniach firmowych to zwykle ważniejsze niż sama elokwencja odpowiedzi.
Jeśli rozważasz wdrożenie RAG w swojej firmie, zacznij od audytu bazy wiedzy i dwóch tygodni pilotażu na realnych dokumentach. Vendor, który obiecuje RAG bez sanitacji bazy, sprzedaje Ci porażkę.
Zobacz również:
n8n vs Make: porównanie platform do automatyzacji workflow
Czym jest AWS -Amazon Web Services?
React vs Next.js: Który framework wybrać w 2026 roku?
Testowanie frontendu: kompletny przewodnik dla początkujących i praktyków